Слив Google Content Warehouse, материалы суда US v. Google, патенты, руководство для асессоров обычно разбирают по отдельности. Один блогер раскопал поля из слива, другой процитировал показания из суда, третий нашел интересный патент. А потом каждый делает выводы на основе одного кусочка мозаики.
Мы решили сложить все вместе.
Коротко о главном
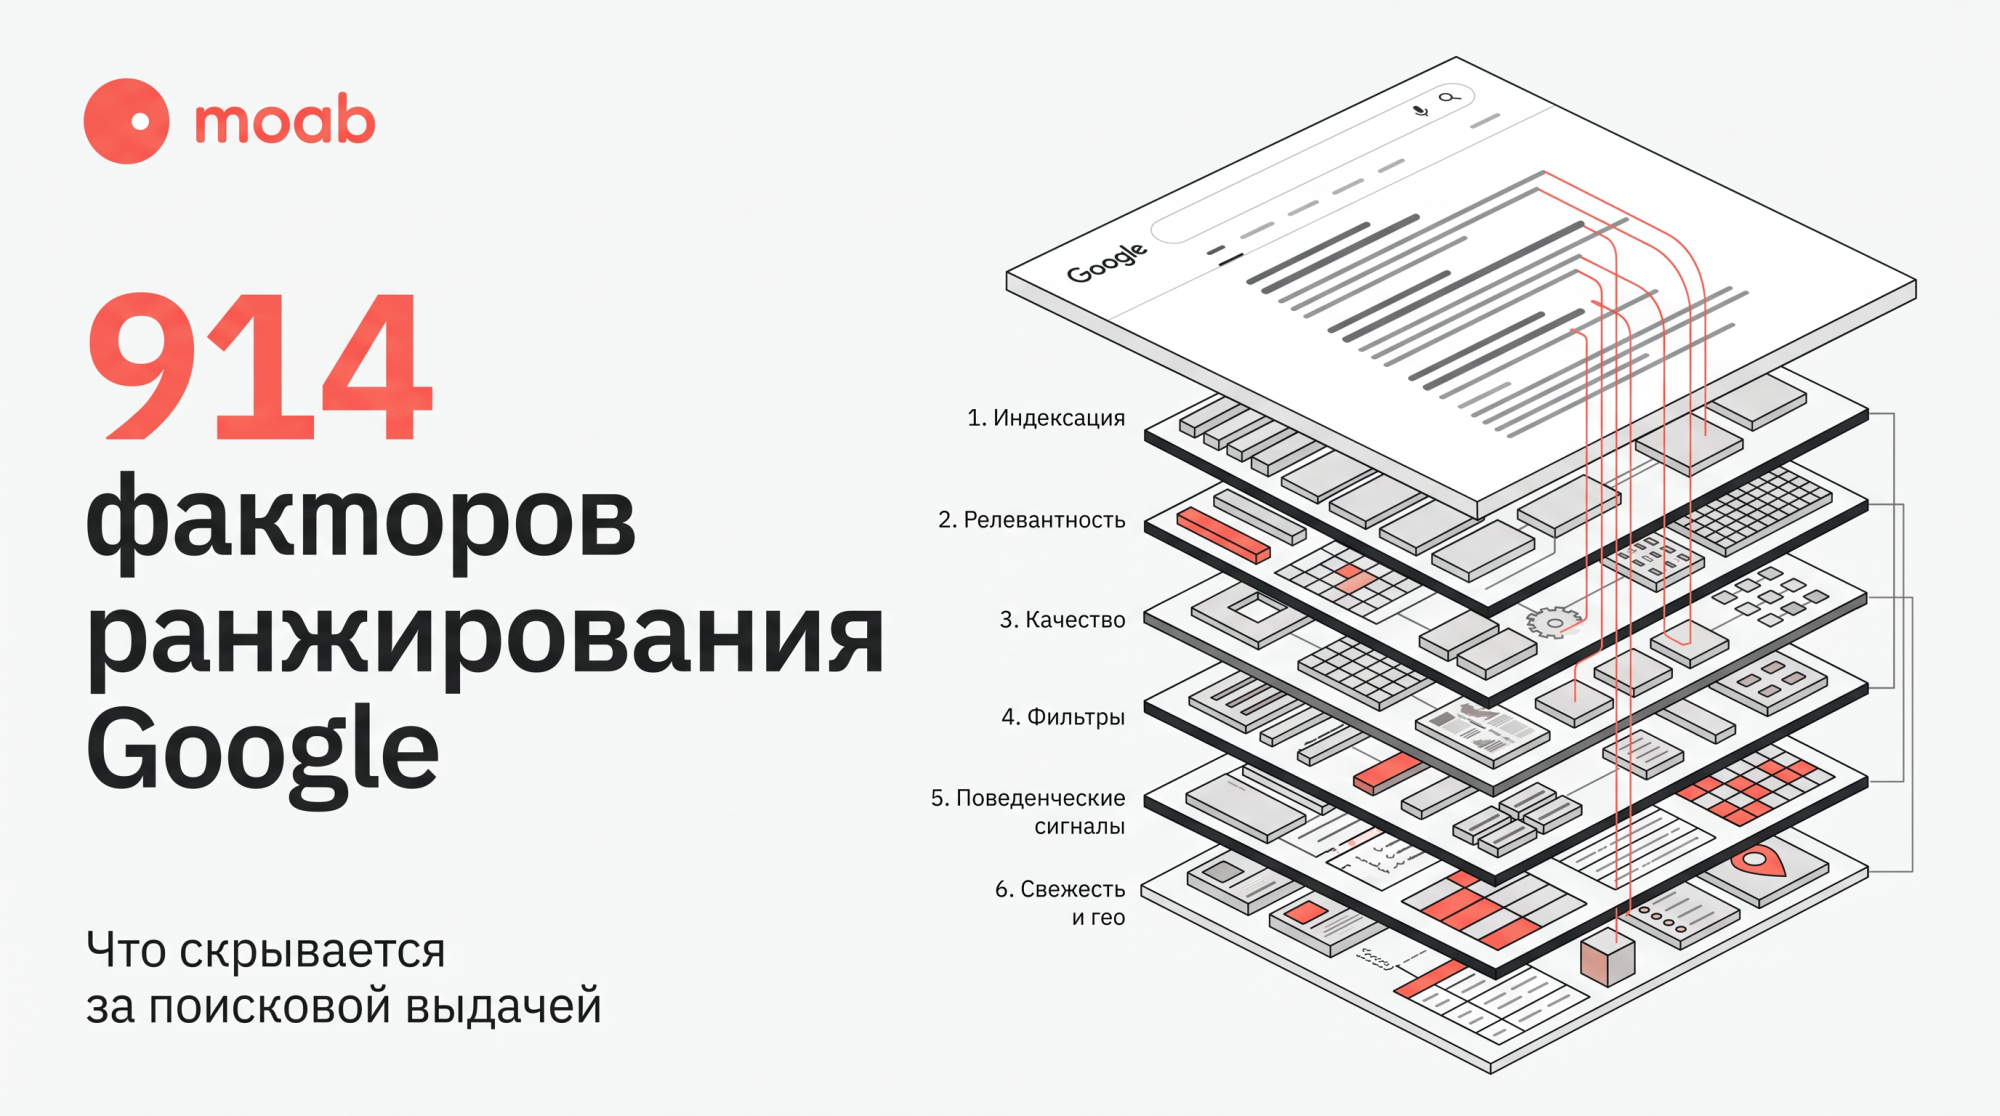
- Пять слоев данных после перекрестной проверки дали 914 канонических факторов ранжирования плюс 404 патентные карточки-гипотезы.
- Ранжирование — не формула, а цепочка систем. Для аудита ее удобно разбирать по шагам: доступность → релевантность → качество → штрафы → поведенческие сигналы → свежесть и гео. Страница может ломаться на любой стадии.
- NavBoost — судебно подтвержденная система, которая агрегирует клики за 13 месяцев. Работать нужно не с кликами, а с соответствием сниппета и страницы.
- В сливе видны поля четырех моделей качества (Chard, Tofu, Keto, Rhubarb) — и на уровне страницы, и на уровне сайта. Массив слабых страниц тянет вниз все.
- PageRank не мертв. Судебно подтвержден как ключевой вход в Q* — главный сигнал качества и доверия.
- Google работает с сущностями (WebRef), а не с keyword density. Страница должна центрально раскрывать одну сущность, а не размываться.
- Штрафные системы (Panda, Racter, Clutter) — отдельные сигналы внутри оценки качества. Можно иметь хороший контент и одновременно ловить демоушен за массив или за высокую долю автогенерированного контента.
- Чтобы ваш ИИ-агент проверял страницы по этой базе, мы собрали MCP-сервер seo-factors. Релиз — в конце статьи.
- Полная методичка со всеми факторами, матрицей подтверждения и playbook — там же, в конце статьи.
Как собран корпус: пять слоев и перекрестная проверка
Наш исследовательский отдел собрал пять слоев данных — утечку Content Warehouse (~2600 модулей и ~14 тысяч атрибутов в полном сливе), судебные материалы US v. Google 2020–2025 годов, включая remedies-фазу, первичные патенты Google, Search Quality Rater Guidelines и, пятым слоем, каталог патентной сверки из 2365 записей — и прогнал их через перекрестный анализ. Тяжелую работу по парсингу, очистке и сопоставлению делали LLM-агенты. Потому что это десятки тысяч полей слива и тысячи патентных записей, которые нужно было сопоставить друг с другом и не растерять по дороге.
На выходе — методичка с 914 каноническими факторами ранжирования и матрицей кросс-подтверждения. Плюс отдельный патентный слой: сверка с этим каталогом выявила еще 404 механизма, большинства из которых не было в базе слива. Для каждого фактора видно, какие источники его фиксируют и насколько сильна доказательная цепочка.
Самое интересное в этом — пересечения. У 79 факторов свидетельства сходятся из разных классов источников: например, судебные показания подтверждают то, что видно в сливе. Спорными остаются два фактора: сигнал популярности P* на данных посещений Chrome и роль спам-скора как гейта индексации. По ним свидетельства и публичные трактовки расходятся.
Значит ли это, что мы нашли формулу ранжирования? Нет. Мы знаем, что Google измеряет, но не знаем, сколько каждый сигнал весит. Утечка показывает поля, но не веса. Суд подтверждает только архитектуру и не подтверждает коэффициенты. Мы собрали направления для аудита и проверяемые гипотезы.
И еще одно, чтобы сразу снять вопрос 2026 года: зачем разбирать классическое ранжирование, когда внимание уехало в AI Mode и AI Overviews? Затем, что AI Overviews стоят поверх той же поисковой инфраструктуры: по материалам суда, система берет результаты поиска и уже из них LLM собирает ответ — то есть кандидатов отбирает и ранжирует тот же конвейер: индекс, качество, авторитет, сущности. С Gemini сложнее: его Google заземляет через отдельную систему FastSearch, которая берет меньше документов и дает выдачу похуже полной. Так что все, что ниже, — фундамент и для «синих ссылок», и для цитируемости как минимум в AI Overviews.
Конвейер ранжирования: где именно ломается видимость
Google не оценивает страницу одним скором и не сортирует результаты одной формулой. Внутри — цепочка систем, каждая со своей задачей. Одни решают, попадет ли документ в индекс, другие считают релевантность, третьи — качество, четвертые — риски. Жесткий отсев подтвержден только для индекса: если страница не прошла туда, до остальных систем она просто не доходит.
В методичке мы собрали эту цепочку по корпусу источников — как модель для аудита, а не как схему Google. Ее звенья:
-
Доступность и индексный слой. Попал ли документ в отбор. Robots, noindex, canonical, fetch, статусы, serving-tier, crawl budget. Если страница не проходит здесь — дальнейшие сигналы не работают.
-
Релевантность (ABC). Соответствие запросу: анкоры (Anchors), тело документа (Body), клики (Clicks), топикальность. Страница должна явно отвечать на интент, а не просто повторять ключевые слова.
-
Quality / Q.* Авторитет и качество на уровне сайта и страницы. NSR, siteAuthority, четыре модели качества контента (Chard, Tofu, Keto, Rhubarb), Content Effort. В основном статический сигнал: страница приходит в ранжирование с уже готовым контекстом доверия.
-
Демоушены и фильтры риска. Отдельные сигналы, встроенные в оценку качества. Panda, Racter, Clutter, Keyword Stuffing — каждый со своим детектором.
-
Поведенческие сигналы и NavBoost. Агрегированные click-and-query данные за 13 месяцев. Good/bad clicks, возвраты к выдаче, удержание. Работают на уровне запроса, URL, гео, языка и времени.
-
Свежесть, локальность, финальные корректировки. Свежесть через LSU и QDF, гео-контекст, язык, E-E-A-T-рамка. Не универсальные бусты — работают только там, где интент требует свежего или локального результата.
Это порядок вопросов для любого подобного аудита: участвует ли документ в отборе? Потом — релевантность, качество, риски, и только после этого тонкие корректировки. В каждом из шести блоков — десятки документированных сигналов. Дальше мы разберем ключевые, но сначала — о том, как вообще устроены доказательства в методичке, чтобы отличать сильные выводы от слабых.
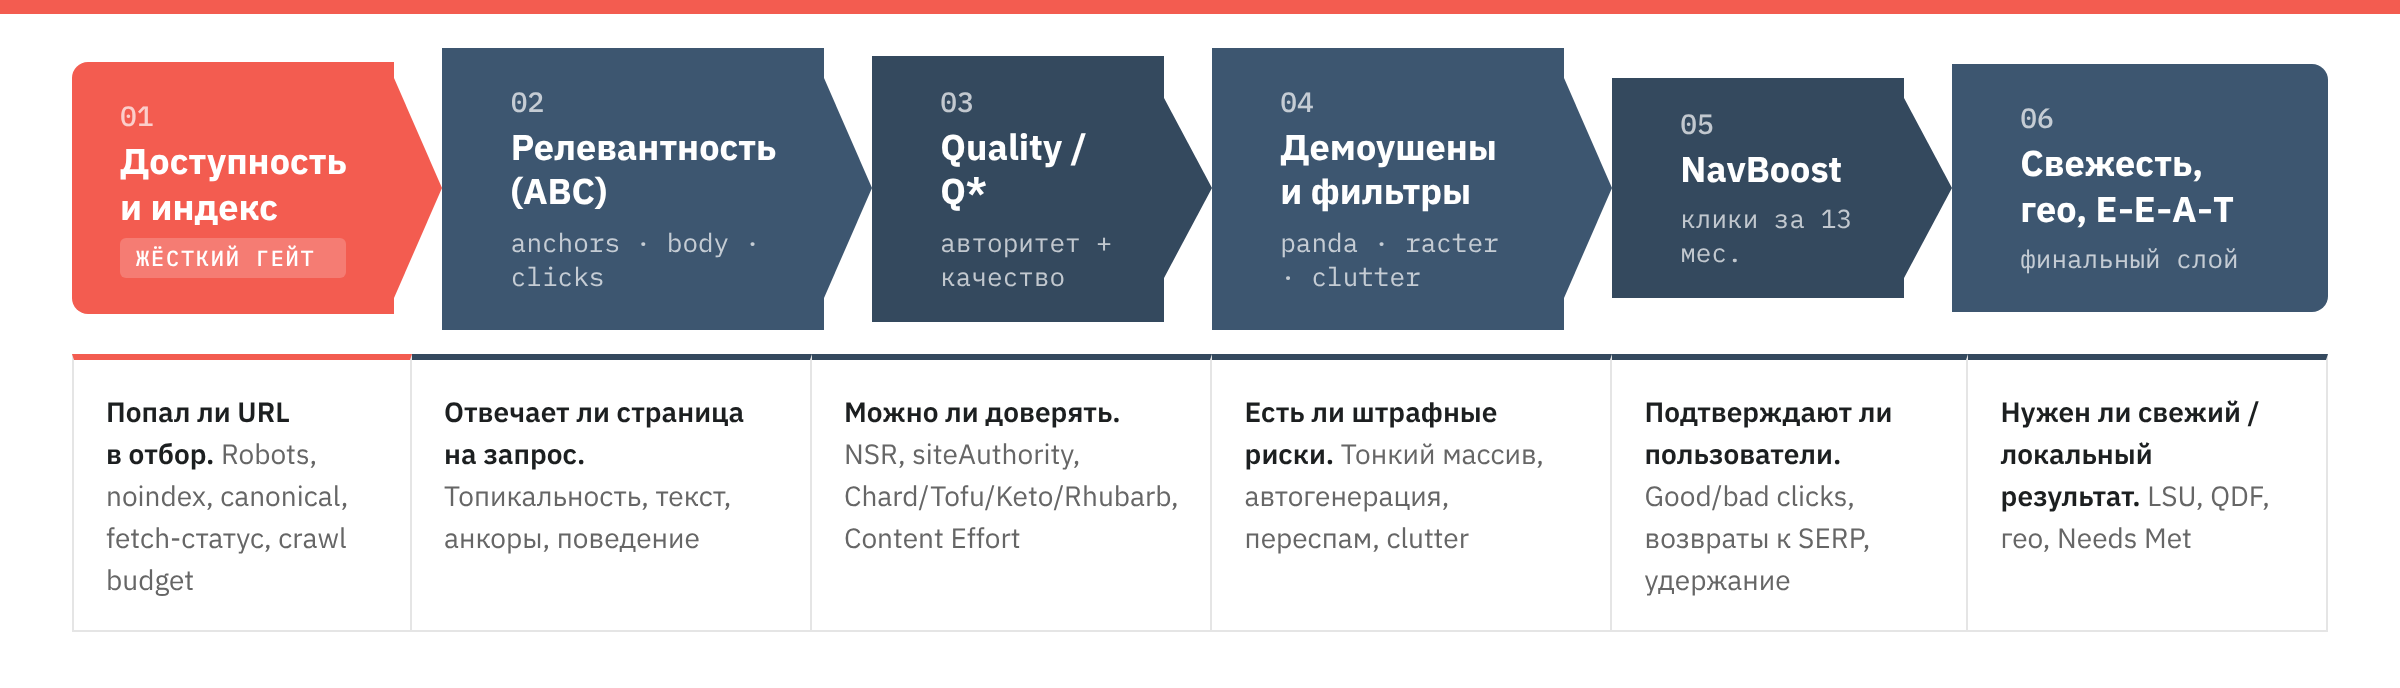
Конвейер ранжирования Google: шесть стадий, через которые проходит каждая страница
Как устроены доказательства в методичке
Для каждого из 914 факторов важно не только «что нашли», но и «откуда знаем». Пять типов источников дают разную степень уверенности:
LEAK (утечка Content Warehouse) — показывает, что поле или модуль существует в коде. Не раскрывает вес, порог и активность в продакшене.
COURT (материалы суда US v. Google) — полезен для архитектуры и подтвержденных внутренних систем. Не раскрывает весь алгоритм. В корпус входят и материалы remedies-фазы 2025 года — например, экспонат PXR0356, беседа с инженером HJ Kim (февраль 2025).
PATENT (первичные патенты Google) — пять публикаций, объединенных в четыре патентных семейства. Патент объясняет механизм, но не доказывает, что он используется именно сейчас и именно в таком виде. Номера одного семейства не считаются независимыми подтверждениями.
QRG (Search Quality Rater Guidelines) — целевая рамка качества для обучения и валидации ML-моделей. Не список прямых коэффициентов.
GPATENT (слой патентной сверки) — сверка с дополнительным каталогом из 2365 записей, давшая 404 механизма, большинства из которых в базе слива не было. Источник вторичный (пересказы): с первичным текстом патента сверены 11 механизмов, остальные — гипотезы уровня «механизм описан в патенте», а не доказательство продакшена. Каталог покрывает разные продукты Google, и его полнота не установлена, поэтому называть его «всеми патентами о ранжировании» нельзя.
Когда несколько типов источников указывают на один механизм, доказательная цепочка крепче. Мы ввели шкалу уверенности:
Перекрестное подтверждение (79 факторов) — самый сильный класс: фактор связан минимум с двумя классами источников, например слив плюс судебные показания. У 63 из них одна из связей — вторичный патентный каталог, так что по первичным источникам класс уже: 21 фактор.
Однотипное подтверждение (4) — несколько независимых документов одного класса.
Документирован (829) — один доказательный слой. Это не «слабый фактор»: поле из слива может быть важным, просто второго подтверждения пока нет.
Спорный (2) — источники или их публичные интерпретации расходятся.
Класс уверенности — это оценка фактора целиком. А вот статусы висят на конкретных тезисах: отдельно «подтверждено ли описание механизма» и отдельно «известно ли, что Google применяет его прямо сейчас».
Вот как перекрестная верификация выглядит на практике. Возьмем PageRank:
LEAK: поля PerDocData.pagerank, homepagePagerankNs. Поле pagerank помечено как устаревшее, используется значение из другого модуля (MustangBasicInfo).
COURT (стр. 143, плюс экспонат PXR0356): PageRank назван одним из главных входов в Q* — «расстояние от известного хорошего источника» в ссылочном графе.
Оба независимых слоя сходятся: PageRank жив и работает как ключевой вход в систему качества. Именно за такими связками мы и охотились по каждому из 914 факторов.
Клики решают? NavBoost и 13-месячная память Google
NavBoost — одна из core ranking моделей Google, работающая с агрегированными click-and-query данными за 13-месячное окно.
На суде о ней говорили два свидетеля с разных сторон. Представитель Google (Lehman) описал NavBoost как «систему запоминания» и «гигантскую таблицу», в которой Google хранит историю взаимодействий пользователей с результатами поиска. Представитель Microsoft (Parakhin) объяснил сам принцип: если по запросу уже кликали, хорошие результаты можно «запомнить». У частотных запросов в этой таблице — длинная, плотная история, и сдвинуть устоявшийся расклад сложнее, чем у запросов с коротким хвостом данных.
Рядом с NavBoost работает Glue — расширенный лог взаимодействий с выдачей, который учитывает не только клики, но и другие действия на странице результатов. А в данных утечки видны поля goodClicks и badClicks в CRAPS-сигналах: Google делит клики по качеству. Описания у полей пустые, но вероятный критерий — время до возврата к выдаче: именно так сигнал Clicks описан в экспонате PXR0356.
На практике SEO-специалисту нужно наращивать goodClicks и снижать badClicks. Это два разных направления. Первое — работа со сниппетом в выдаче: title, description, хлебные крошки, фавикон. Если по запросу много показов, но мало кликов — пользователь видит сниппет и проходит мимо: либо заголовок не попадает в интент, либо конкуренты выглядят убедительнее. Второе — работа с самой страницей: если CTR хороший, а пользователь быстро возвращается к выдаче, то страница не закрывает задачу, и, скорее всего, это и есть badClick. Диагностика обоих случаев начинается в GSC.
Отдельный риск — попытки накрутить поведенческие факторы. В утечке есть антифрод-модели, а на уровне сайта работают штрафные системы, о которых мы расскажем ниже, в карте рисков. В патенте Google как защита от накрутки описаны агрегация кликов со сглаживанием: один голос на cookie/IP, а источники с аномальными паттернами удаляются из расчета целиком. Применяется ли это сейчас, неизвестно.
Q* и модели качества: как Google на самом деле считает качество
Q* — верхнеуровневый сигнал доверия и качества, привязанный к сайту. В судебном экспонате PXR0356 (запись беседы с инженером Google) он описан как в основном статичный. Страница, как правило, не получает «качество» под каждый запрос заново, а приходит в ранжирование с уже готовым контекстом. Лишь в отдельных случаях Q* учитывает запрос. Один из ключевых входов в этот контекст — PageRank.
Помимо Q*, в утечке видны поля четырех отдельных моделей качества:
Chard — предиктор качества сайта на основе контента. В сливе есть его поля и на уровне URL, и на уровне сайта.
Tofu — второй предиктор, отдельная модель, отдельное поле. Тоже на уровне URL и сайта.
Keto — третья модель. В сливе о ней одна строка, Keto score; назначение не описано.
Rhubarb — самая интересная. Считает не абсолютное качество, а дельту между качеством конкретной страницы и средним по сайту. Положительная дельта — страница лучше среднего уровня домена. Отрицательная — хуже.
Как эти четыре модели сочетаются между собой и с Q*, слив не показывает.
Рядом с ними в сливе лежит Content Effort — LLM-оценка вложенных усилий для статейных страниц. Google прогоняет страницу через собственную языковую модель и оценивает, сколько реальной работы за ней стоит. Оригинальные данные, экспертный анализ, конкретные примеры, структурированная аргументация — признаки высокого качества контента. Шаблонные «10 советов» без глубины — зона риска.
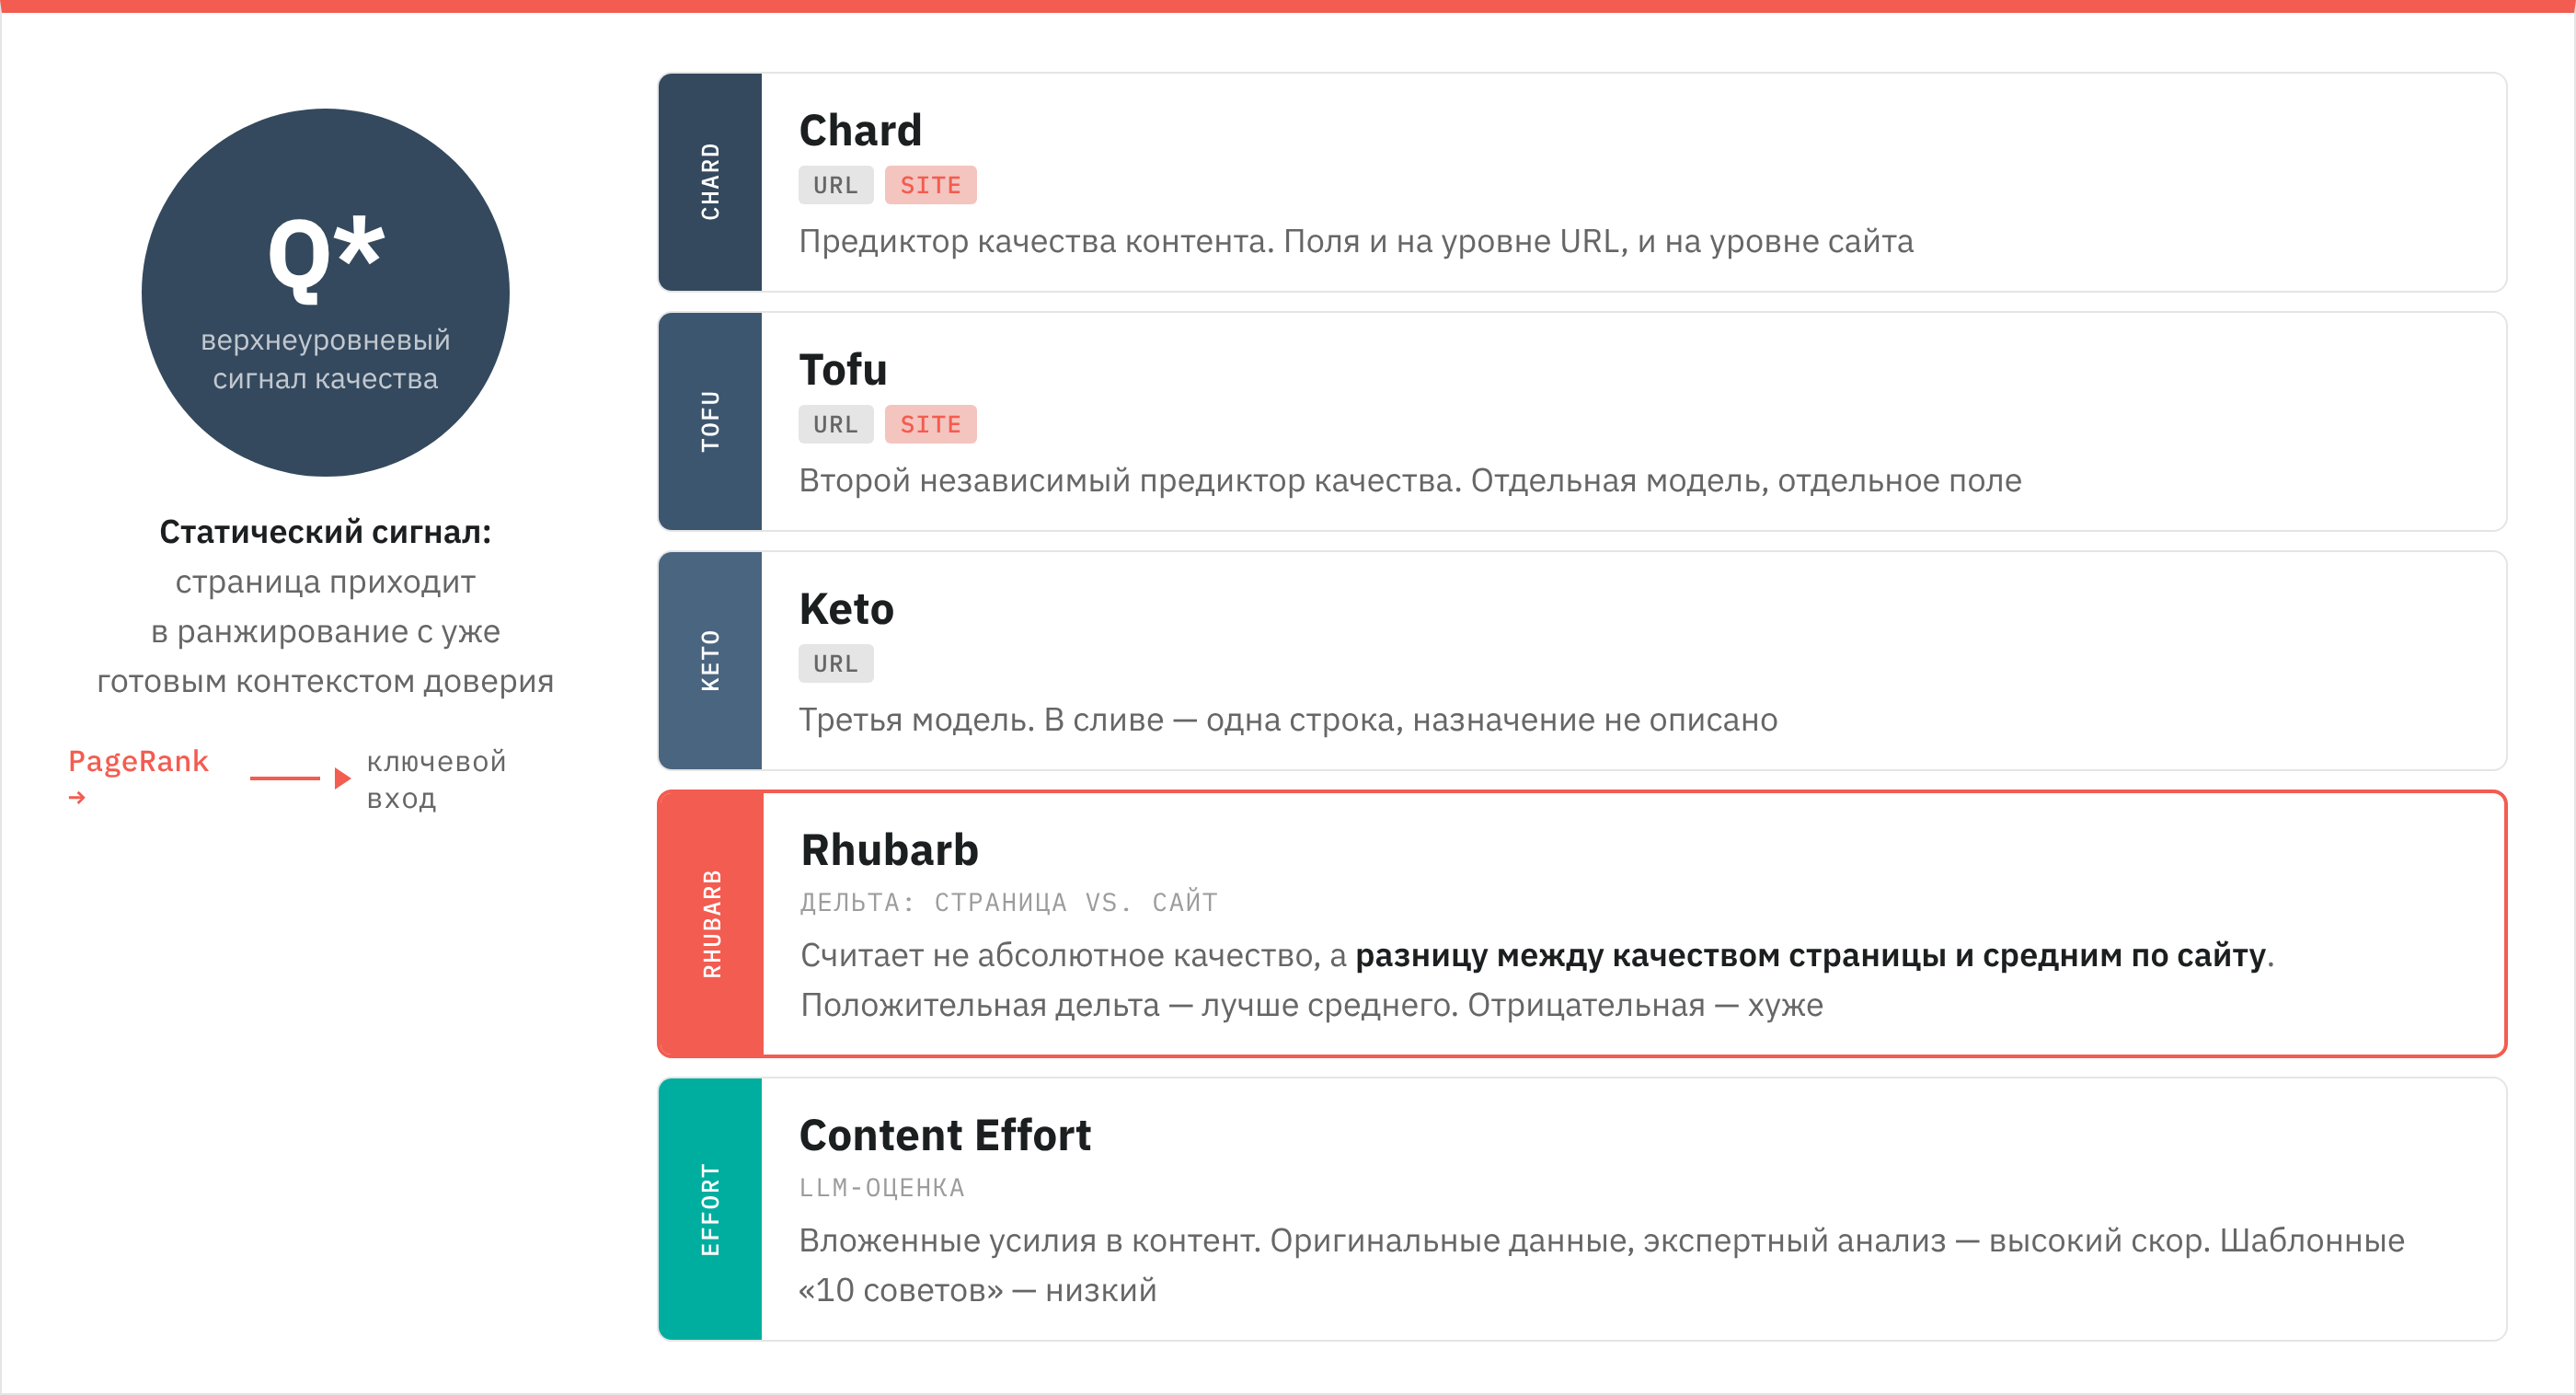
Q* и пять моделей качества внутри оценки Google
Почему это меняет логику оптимизации
Ключевое: судя по данным утечки, у Chard и Tofu есть не только URL-уровневые, но и site-level поля. Там же видны и другие сигналы авторитета домена (подробности — в методичке) — все указывает на то, что Google оценивает домен целиком.
Допустим, у вас e-commerce с тысячей шаблонных карточек товаров и десятком экспертных обзоров в блоге. Обзоры сильные, карточки слабые. Rhubarb-дельта у обзоров будет положительная — они выше среднего по домену. Но средний уровень задается массивом. Если слабых страниц в тысячу раз больше, чем сильных, он проседает, и даже хорошие обзоры, вероятно, получают меньший буст, чем могли бы на чистом домене.
Контентный проект с пятью глубокими исследованиями и двумя тысячами автогенерированных страниц под города и под запросы — это не «сайт с хорошим блогом», а сайт с доминирующим массивом мусора и пятью исключениями. Поэтому главный вопрос, который стоит задавать перед публикацией каждой новой страницы: «Она входит в сильную половину нашего сайта или тянет медиану вниз?»
PageRank жив: ссылки как вход в систему доверия
Мы уже показали выше, как PageRank подтверждается двумя независимыми слоями источников. Теперь — о том, что из этого следует для работы со ссылками.
Нарратив «PageRank мертв» держится в индустрии давно. В данных — обратная картина. PageRank судебно подтвержден как ключевой вход в Q* и измеряет расстояние от «известных хороших источников» в ссылочном графе. Чем ближе ваш сайт к доверенной части графа, тем сильнее стартовая позиция.
Это работает не только на уровне отдельных страниц. В утечке есть поле homepagePagerankNs — PageRank главной, который копируется в каждую внутреннюю. По нашей оценке, это прокси авторитетности домена. Ссылки на главную усиливают не только ее. Они могут поднимать базовый уровень для всего сайта.
Еще один внутренний механизм — Onsite Prominence: в утечке видна симуляция трафика от главной и от высококликабельных страниц по внутренним ссылкам. По сути, аналог PageRank, но внутри домена. Если ключевая посадочная страница ни разу не упомянута в популярных разделах, значит, ее внутрисайтовая значимость ниже, чем могла бы быть. Проверяется в GSC → «Ссылки» → «Внутренние ссылки»: сколько внутренних ссылок получают ваши приоритетные URL и с каких страниц.
Наконец, доноры: ссылки с площадок с высоким авторитетом несут дополнительный сигнал. В утечке это видно через поле AnchorsAnchorSource.nsr: ссылка с авторитетного донора передает не просто «вес», а еще и привязку к уровню авторитета источника.
Теперь обратная сторона. SpamBrain LAVC — сайт-уровневый скор, описанный в сливе одной строкой: «The SpamBrain LAVC score, as of July 2022». Что именно он оценивает, не раскрыто, связь со ссылочным профилем — наша гипотеза. Если она верна, признаки риска те же, что у любого антиспама по ссылкам: резкий прирост за короткий период, ссылки с однотипных площадок, ссылочные прогоны. Anchor Mismatch — рассинхрон между тем, что обещает анкор, и тем, что находится на странице.
На практике из этого блока вытекают три вещи. Внешние ссылки: приоритет — доноры, близкие к доверенной части графа (редакции, gov/edu, отраслевые ассоциации), а не набор слабых периферийных размещений. Внутренние ссылки: приоритетные посадочные страницы должны получать ссылки с главной и из трафиковых разделов, это прямая работа с Onsite Prominence. И гигиена: ссылочный профиль стоит регулярно проверять через Ahrefs или GSC, чтобы в профиле не накопился подозрительный паттерн, который вы не заметили.
Сущности вместо ключевых слов: как Google читает ваш контент
Когда SEO-специалист смотрит на страницу, он видит ключевые слова: вхождения, плотность, LSI. Когда Google смотрит на ту же страницу, он видит сущности: объекты из Knowledge Graph с идентификаторами, привязками и весами.
За это отвечает аннотатор WebRef. При индексации он прикрепляет к документу массив сущностей — каждая с MID (идентификатор в Knowledge Graph), показателем топикальности и уровнем уверенности. Массив отсортирован по убыванию топикальности: какая сущность главная для этой страницы, какая второстепенная, какая упомянута вскользь. Это зафиксировано в утечке — LEAK, несколько полей.
Топикальность — это доля документа, посвященная сущности, в данных слива она хранится как нормализованная величина. Страница, целиком посвященная «iPhone 16 Pro», даст более ясный entity-сигнал, чем статья «20 лучших гаджетов», где iPhone — один пункт из двадцати. Посторонние сущности размывают долю целевой.
В утечке видно поле уверенности (confidence) — насколько система уверена, что сущность реально присутствует в документе. Судя по данным, упоминания в title и h1 весят больше обычного текста.
Есть и еще один механизм — reference pages. В сливе у сущности (бренд, персона, продукт) есть список таких очень топикальных страниц, по которым Google добирает данные о ней. Для компании это, например, Википедия и ее собственный сайт. Если у вас есть подробная страница о компании или продукте — полная информация, согласованные факты, schema-разметка (Organization/Person/Product), внешние ссылки и упоминания — она может попасть в этот список. Влияет ли это на позиции, слив не говорит, но Google будет точнее понимать, кто вы и о чем ваш сайт.
Отдельная история — авторство. WebRef связывает документ с автором и издателем как с сущностями в графе знаний, а не просто как с текстом в футере. Для этого Google использует поля isAuthor, isPublisher и profileUrl — ссылку на профиль автора, по которой можно подтвердить связь. Разработано в первую очередь для новостных статей, но логика распространяется шире. Чтобы Google идентифицировал автора, нужна schema-разметка (schema.org/author) со ссылками sameAs на проверяемые профили — личный сайт, Google Scholar, LinkedIn. Тогда «Иван Петров» в подписи превращается для Google из строчки текста в конкретный узел графа знаний.
Вот что стоит сделать на своем сайте:
- Сфокусировать страницу на одной сущности, не размывать десятком побочных тем.
- Каноническое имя сущности поставить в title, h1 и в анкоры внутренних ссылок.
- Автора разметить через schema.org/author с sameAs на устойчивые профили.
- Для бренда или продукта создать на сайте подробную reference-страницу — полная информация, разметка, внешние упоминания — чтобы Google было откуда добирать данные о сущности.
Карта рисков: штрафные сигналы внутри оценки качества
Четыре модели качества (Chard, Tofu, Keto, Rhubarb) — это «положительная» сторона оценки. Но внутри той же оценки качества есть и штрафные сигналы (Clutter, например, описан в сливе как site-level дельта в Q*) — каждый со своим детектором и своим уровнем воздействия. Сайт может получать приличные оценки по Chard и Tofu и одновременно ловить демоушен по другому сигналу. Именно поэтому диагностика по одному слою не снимает риски по другому.
Действуют следующие системы:
Panda и BabyPanda v2 — штраф за тонкий, дублированный или массовый низкокачественный контент. Бьет не по конкретной странице, а по всем страницам домена. BabyPanda v2 — новая версия демоушена, которая применяется поверх Panda. Слив не описывает, что именно она оценивает. В любом случае оценивать Google будет то, что видит он, а не вы: проверьте через URL Inspection в GSC → «Просмотреть отрендеренную страницу».
Racter — сайт-уровневая оценка автогенерированного контента, зафиксированная в утечке. По сливу не видно, что именно считается риском. По нашей гипотезе, опасна не сама генерация, а большая доля текстов без редакционной ценности. Сотни статей publish-as-is — это сигнал на уровне сайта.
Clutter Score — штраф за сайт, на котором реклама мешает контенту. Агрессивные попапы, автозапуск видео, навязчивые баннеры, избыток рекламных сетей и трекеров. Считается на уровне домена. Быстрый тест: откройте сайт с блокировщиком рекламы — если с первого экрана исчезает значительная часть содержимого, clutter-риск стоит проверять. Конкретнее можно проверить через PageSpeed Insights: посмотрите количество сторонних скриптов и ресурсов.
Keyword Stuffing Score и Gibberish Score — два отдельных скора, каждый по 7-битной шкале (0–127). Первый ловит переспам ключевыми словами, второй — бессмысленный или тарабарский текст. Тест на переспам простой: прочитайте текст вслух. Если звучит как «купить диван недорого купить диван Москва купить диван» — это оно.
Почти все перечисленные системы задокументированы через LEAK: поля и модули видны в сливе, но второго независимого слоя подтверждения у них нет — устройство своих фильтров Google публично не описывает. Сводная карта:
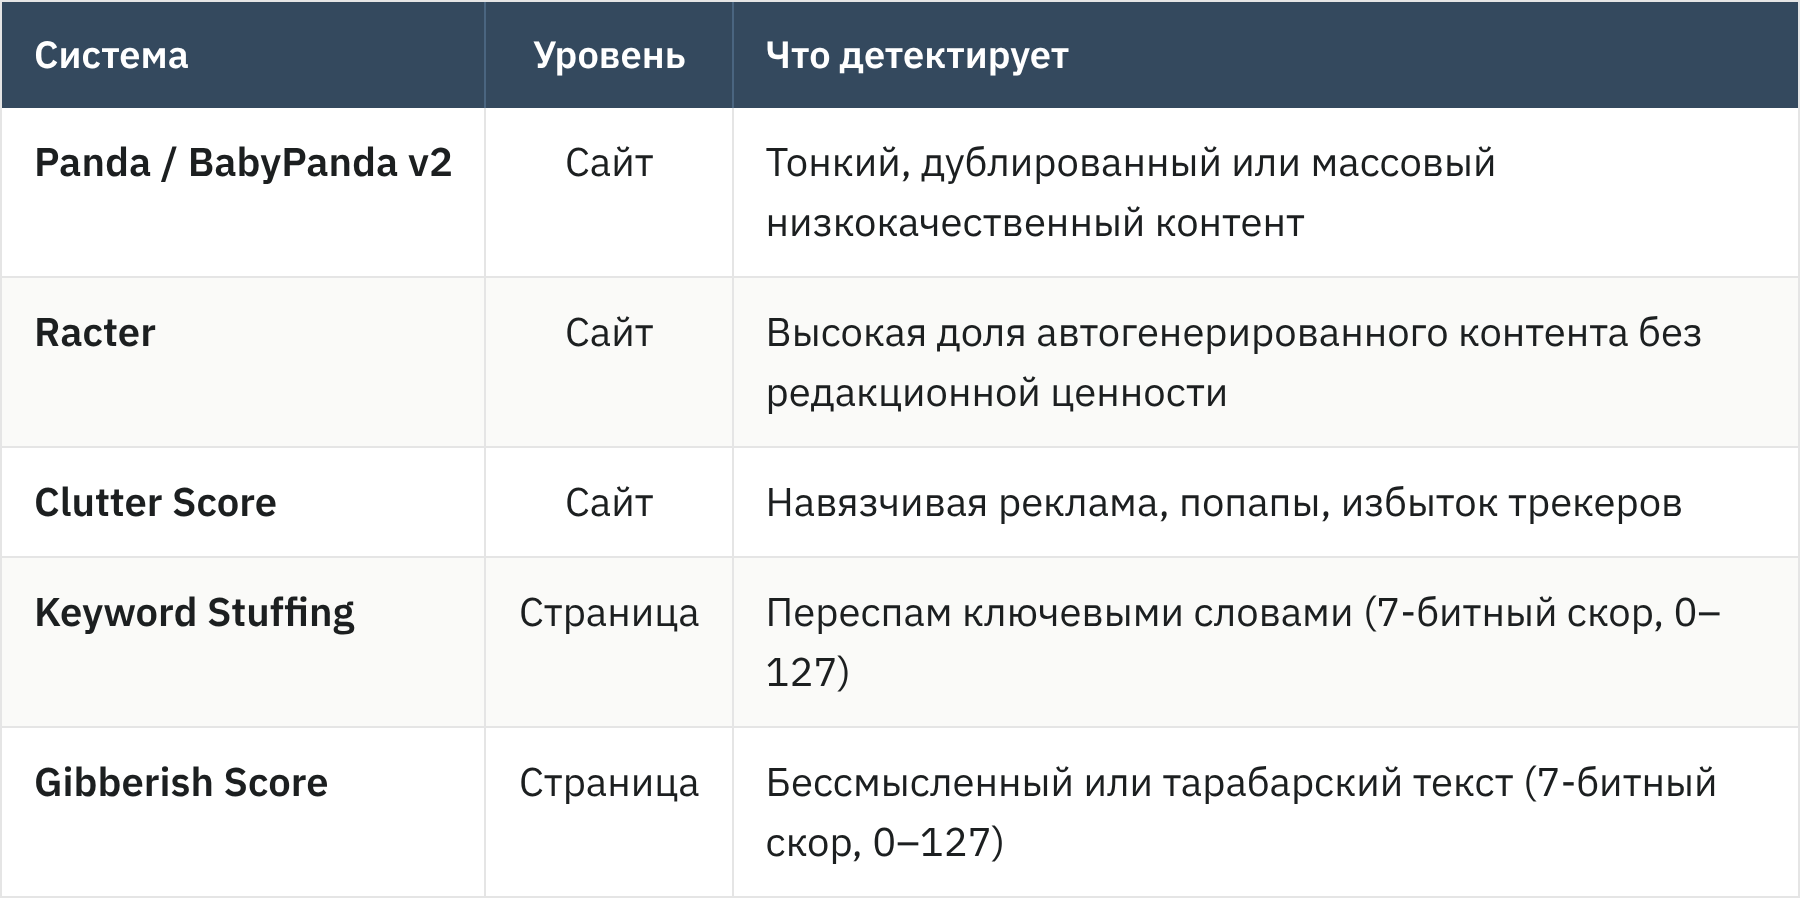
Обратите внимание на колонку «Уровень»: Panda, Racter и Clutter бьют по всему домену, а не только по проблемным страницам. Одна слабая статья — не катастрофа. Массив слабых страниц, который приносит штрафы, — проблема для всех URL на домене, включая те, которые вы не трогали.
Свежесть, гео, QRG: последний слой перед выдачей
После поведенческих сигналов, качества, ссылок, сущностей и штрафов в конвейере остается еще один слой корректировок — финальный. Он не заменяет предыдущие, но может сдвинуть показатели в обе стороны.
Свежесть: обновляйте контент, а не дату. В утечке есть механизм LSU (Last Significant Update) и отдельная оценка unreliable-dates. LSU вычисляется из нескольких сигналов, поэтому одна смена даты, скорее всего, не сработает. Для time-sensitive запросов («курс доллара сегодня», «результаты выборов») свежесть работает через QDF — Query Deserves Freshness: система понимает, что по этому запросу нужен свежий результат. Для evergreen-запросов («как оформить ИП») свежесть даты сама по себе ничего не дает — важно, что изменилось в содержании. Практический ориентир: если законодательство обновилось, ставки изменились, продукт пережил апдейт, обновите факты в тексте, а не только цифру в мета-теге.
QRG — рамка, к которой стремятся модели. Search Quality Rater Guidelines (версия от сентября 2025, 182 страницы) — это не прямой алгоритм ранжирования, а инструкция для асессоров: людей, которые оценивают результаты поиска вручную. Их оценки Google использует для обучения и валидации ML-моделей. QRG полезна как чек-лист: какие свойства страницы Google считает целевыми.
Два главных критерия в QRG:
Needs Met — насколько результат удовлетворяет интент. Главный рейтерский вопрос: получил ли пользователь то, за чем пришел? Страница может быть отлично написана, но если она отвечает не на тот вопрос, оценка будет низкой.
E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) — рамка доверия. Для обычных информационных страниц достаточно понятной экспертизы и прозрачности. Для YMYL-тематик (финансы, здоровье, безопасность) требования резко выше: автор, рецензент, источники данных, репутация издателя — все это должно быть проверяемым.
Гео и локальность. В утечке видны metro-level сигналы, языковой детектор Rosetta (определяет топ-2 языка документа), поля гео-контекста и NAP-сигналы. Для запросов с visit-in-person интентом («стоматология рядом») локальные доказательства (адрес, телефон, локальные ссылки, региональный контент) работают как фильтр: без гео-привязки страница, вероятно, проиграет локальным результатам.
Свежесть и гео срабатывают только там, где этого требует интент запроса. А по Needs Met и E-E-A-T пройдитесь вручную по своим ключевым страницам и оцените их глазами асессора.
Все в одной таблице: 11 категорий, 914 факторов
Ниже — сводка по всем категориям методички. Для каждой указано количество факторов и коротко, что внутри.
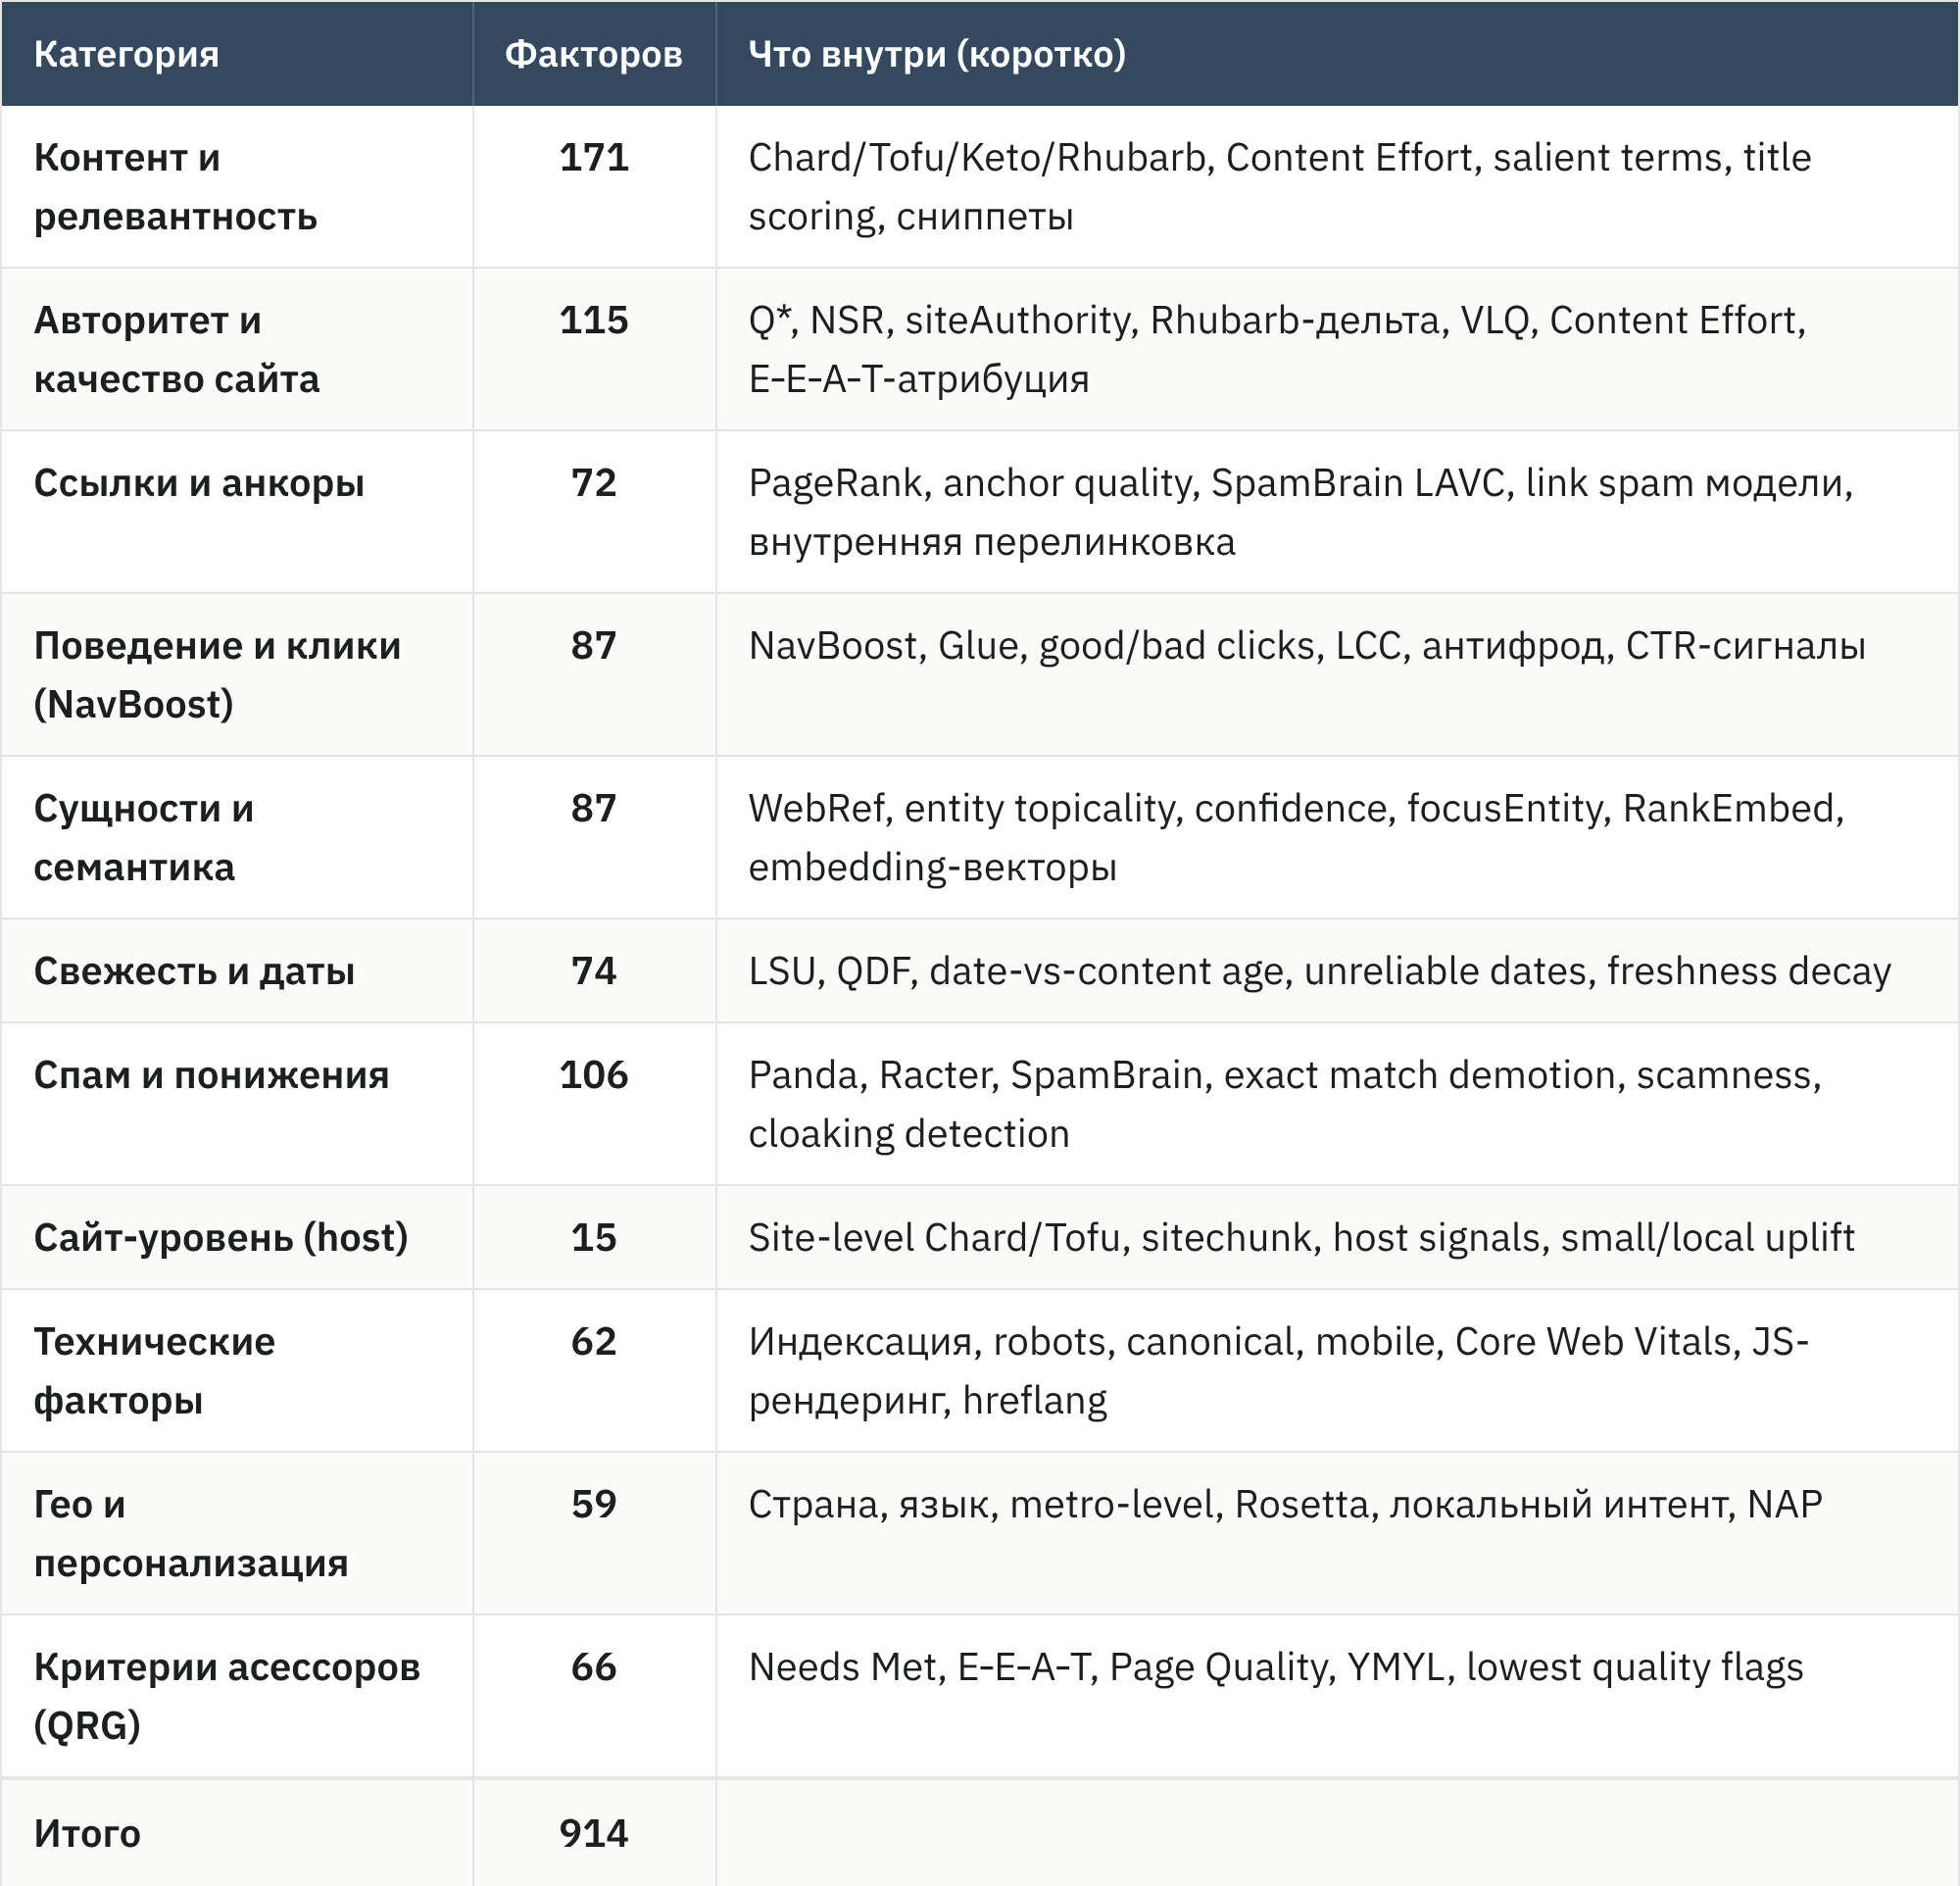
Два наблюдения. Из 914 факторов 79 связаны минимум с двумя классами источников, а 829 опираются на один доказательный слоя. И у 63 из этих 79 одна из связей — вторичный патентный каталог. Без него перекрестно подтвержден 21 фактор, а самая частая связка первичных источников («слив плюс суд») — у 9.
Какой уровень уверенности у каждого из 914 факторов и на какие локаторы он опирается, видно в реестре внутри методички. Ссылка на скачивание — в конце статьи.
С чего начать аудит прямо сейчас
914 факторов — это много. Соблазн кинуться оптимизировать все сразу — понятный, но вредный. Логика приоритизации простая: двигайтесь по конвейеру сверху вниз.
Сначала — гейты, пятиминутная проверка в GSC. Если страница не в индексе, не отдает корректный статус, закрыта от краулера, никакие сущности, ссылки и Content Effort ей не помогут.
Потом — массив. Мы не зря возвращались к этой теме в каждом втором разделе: site-level поля Chard/Tofu, Panda на уровне домена, Racter по доле автогенерации бьют не по одной странице, а по всем. Выгрузите URL, посмотрите честно на тонкие, шаблонные и пустые страницы. По каждой примите решение: удалить, объединить, доработать. Это самый неприятный и самый результативный этап.
И только после этого — сущности, авторство, ссылочный профиль, сниппеты, свежесть. Тут уже работа по конкретным приоритетным URL, а не по массиву.
Метод проверки один для всех этапов: берете группу из 5–20 URL, фиксируете baseline, вносите одно изменение, ждете переиндексацию, сравниваете с контрольной группой, где ничего не трогали. Масштабируете только то, что подтвердилось.
Агент, который ходит по этим факторам: релиз MCP-сервера seo-factors
Весь описанный выше аудит можно делать руками, а можно поручить агенту. Для этого мы собрали MCP-сервер seo-factors (сейчас — бета-версия) — 1318 исследовательских карточек (914 основного корпуса плюс 404 патентной сверки) и 20 разделов аудита, к которым напрямую обращается ваш ИИ-агент: Claude, Codex или любой другой MCP-клиент.
Зачем это нужно, если «ИИ-аудит» умеет изображать любая LLM? Затем, что обычный ИИ-аудит выдумывает чек-лист из головы — из общих знаний о SEO вперемешку с галлюцинациями. С seo-factors агент работает иначе:
- запрашивает у сервера план — страничный аудит, например, раскладывается на 12 разделов;
- для выбранного раздела получает контракт данных: какие блоки обязательны (для тайтла и дат достаточно HTML страницы, для поведенческих понадобятся GSC и веб-аналитика);
- передает наблюдения в виде фактов и получает карточки-кандидаты с адресами атрибутов из слива и честными статусами.
Честность статусов — главное отличие. У каждой находки два независимых поля: «атрибут задокументирован в сливе» и «неизвестно, работает ли прямо сейчас и с каким весом» — та же двухосевая логика, что и в методичке. Формат выводов: не «у вас нарушение», а «вот механизм, вот ограниченный обратимый тест, вот метрика проверки». Если подходящей карточки нет, сервер так и говорит: «Нет надежного совпадения», — и объясняет, каких данных не хватает, вместо того чтобы притянуть похожую. А патент показывается только там, где связь с фактором подтверждена в реестре, и выглядит как описание механизма, а не доказательство текущего применения.
Что нашлось на нашей собственной странице услуг за один прогон:
- У Google есть не просто флаг «плохого» тайтла, а числовая оценка степени его «плохости» (DocProperties.badTitle, DocPropertiesBadTitleInfo.score). По нашим критериям title «SEO для вашего бизнеса» слабый: 22 символа, без бренда, без типа услуги и без пересечения с формулировками реальных запросов.
- Совпадение запроса с тайтлом (queryMatchFraction) считается по оригинальным словам, без синонимов: «продвижение сайтов» и «SEO для бизнеса» для этого признака — разные вещи.
- Из 19 дат в разметке страницы ни одна не говорила о свежести контента: 19 значений datePublished от отзывов и ни одного dateModified, при том что главный сигнал свежести Last Significant Update рассчитывается не только по дате на странице.
По находкам агент предложил обратимые тесты: переписать title под реальные формулировки запросов, не трогая H1, и сравнить CTR и позиции в GSC до и после, добавить честный dateModified при реальном обновлении контента и посмотреть, подхватит ли дату сниппет.
Подключение: адрес MCP https://lk.moab.tools/kb/books/publicnye-mcp-ot-moab/page/seo-factors, вход через аккаунт lk.moab.tools.
Быстрый старт: https://share.moab.tools/00p52qdf/seo-factors-quick-start-ru.pdf.
Дальше начните с overview, сервер сам подскажет, какой раздел выбрать под вашу задачу и какие данные собрать. Одна оговорка: карточки описывают возможные механизмы, а не гарантии, и решение о внедрении любой рекомендации принимает специалист.
Агент работает с этой базой напрямую, но и вам она пригодится в человекочитаемом виде: все 914 факторов, 404 патентные карточки, матрицу подтверждения и развернутый playbook мы собрали в одну методичку — скачивайте.
Дальше по плану — умный классификатор задач, чтобы агент сам превращал «сделай мне SEO-аудит» во внятный бриф с нужными разделами и данными. Если прогоните через агента свои страницы, расскажите, что нашлось, в комментариях или через Feedback в lk.moab.tools/news.
© Аркадий Мисюров, SEO-специалист, moab


